AI slop

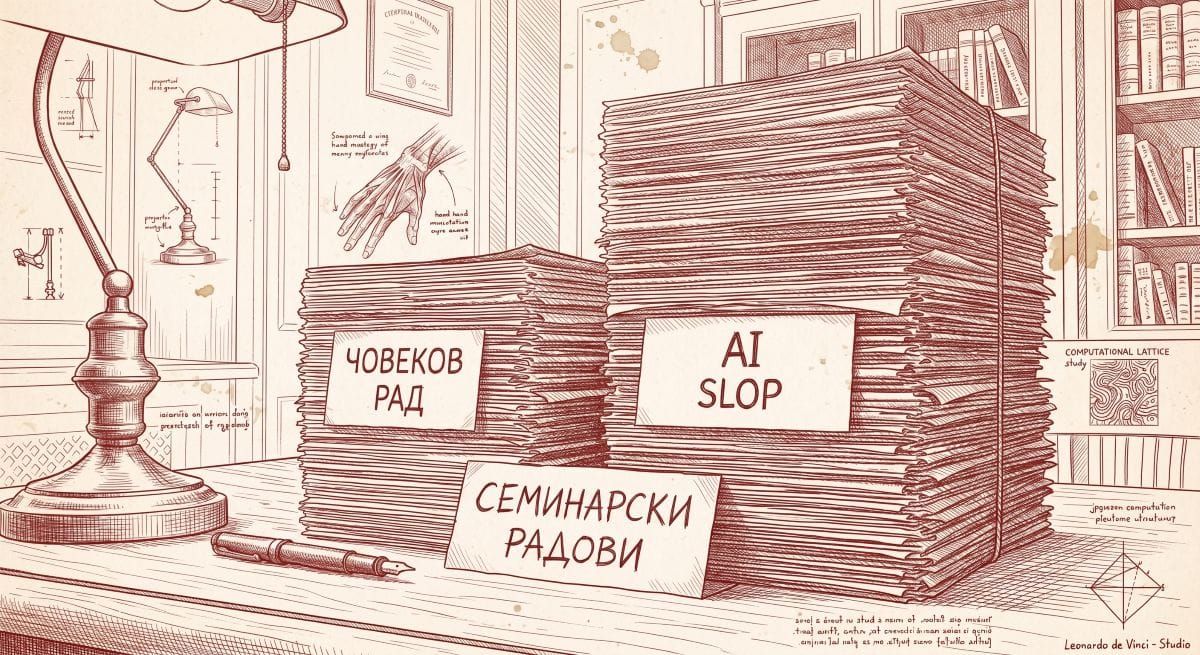
Претпрошли викенд сам одвојио за читање семинарских радова студената, јер је почео септембарски испитни рок. Прочитао сам тридесет један семинарски рад.
После завршеног читања, на столу сам имао две гомиле: није AI и јесте AI. На једној гомили било је девет радова, а на другој двадесет два. Нисам користио софтвер за проверу плагијата нити софтвер за проверу да ли је текст писао AI. После читања првих неколико страна сваког семинарског рада, углавном ми је било јасно на коју гомилу ћу ставити рад.
Кад сам то испричао колеги са катедре, питао ме је како знам да је рад писао AI алат. Нисам умео најјасније да му објасним како, нити сам могао да му набројим правила препознавања. Било је то нешто у ритму писања, у структури реченица, у објашњавањима која су понекад сувишна, нешто у закључку који стигне прерано или понови оно што је написано у уводу. „Једноставно, знам“, рекао сам.
Мислио сам да је то мој, лични утисак. Међутим, испоставило се да није. Појава је идентификована, измерена је, има име, и то име је прошле године ушло у речник.
Реч 2025. године
Merriam-Webster је за реч године изабрао slop. Дефиниција коју су усвојили гласи овако: дигитални садржај ниског квалитета, масовно штанцован помоћу вештачке интелигенције; у ширем смислу: производ мале или никакве вредности. Исти избор за реч године направио је и Economist.
Реч није нова. У осамнаестом веку означавала је прљаву воду или мекано блато. У деветнаестом - помије, све оно што се свињама даје да једу. Одатле је прешла у опште значење безвредног отпада и ту је стајала двеста година, док нам поново није затребала.
Наш најближи превод на српски јесу сплачине. Опис је сликовит, а презир према дигиталном садржају је тачно пресликан, али нико неће рећи „AI сплачине“, па ћемо вероватно остати на енглеској речи, као и обично.
Занимљиво је и како је сам речник објаснио тон те речи: јефтин, без укуса и на брзину произведен садржај којим се затрпава интернет. Slop неприметно испуњава друштвене мреже и медије само зато што га је готово бесплатно и лако стварати у огромним количинама. Није сваки текст или слика настала уз помоћ вештачке интелигенције slop, већ само онај садржај иза којег нема ни ауторске намере ни бриге за читаоца, већ само настојање да се привуку кликови и да се заради на туђој пажњи. Све чешћа употреба те речи показује и да је почетно одушевљење вештачком интелигенцијом почело да уступа место замору због свега чиме је њена масовна употреба затрпала интернет.
Колико га има?
Агенција Graphite мери колики део новообјављених текстова на вебу претежно пишу машине. Од почетка 2025. тај број је близу 50 одсто. У последњем кварталу 2025. био је 50,9 одсто, а у првом кварталу 2026. 49,9 одсто.
Заједничко истраживање Станфорда, Империјал колеџа и Интернет архиве процењивало је број машински направљених нових сајтова уместо појединачних текстова, у којем је резултат био око 35 одсто средином 2025. На Википедији је више од пет одсто нових чланака на енглеском означено као машински написано.
Знам да ће вам бити примамљиво да ове бројке покажете на неком састанку, али уз њих иде и важна напомена. Све су добијене помоћу алата који процењују да ли је текст написао човек или AI модел, а ти алати умеју и људски текст да прогласе машинским и машински да припишу човеку. У „претежно машинске“ сврставају и текстове које је човек написао, а затим поверио моделу на дораду. То ипак није исто што и текст који је модел у целини написао на основу једног упита. А децимала у резултату ту само оставља утисак тачности које заправо нема.
Али када три независна истраживања, спроведена различитим методама и за рачун оних чији су пословни интереси супротни, процењују удео између 35 и 50 одсто, можемо да се споримо око тачне бројке, али не и о томе да ли ова појава постоји.
LinkedIn, или где се то најбоље види
Фирма Originality.ai је током 2025. прегледала 3.368 дужих објава са 99 утицајних LinkedIn профила. Вероватно машински написаних текстова било је 53,7 одсто.
У јулу 2026. поновили су мерење на 5.000 јавних објава. Сада је резултат био 81 одсто.
За непуне две године удео је порастао са половине на четири петине. Конкурентска компанија Pangram применила је строжи критеријум за анализу и посматрала само објаве дуже од 250 речи. Добила је око 41 одсто; бројка је мања, али је слика остала иста.
Још је занимљивији налаз из истог истраживања који се ретко помиње. Објаве означене као машински написане добијале су у просеку 45 одсто мање реакција (лајкова) од оних које су написали људи. Разлика је била нарочито упадљива у текстовима о стратегији и иновацијама: људски текстови добијали су у просеку око 708 реакција, а машински свега 143. И то баш тамо где се пише о вођењу предузећа и доношењу одлука, што су управо оне теме у којима тежина написаног текста зависи пре свега од поверења у онога ко пише.
Неко ће приговорити да број лајкова не доказује да ће људи престати да читају после три реченице. Тачно, не доказује. Али онај ко одустане на трећој реченици сасвим сигурно неће лајковати. То је иста појава, само виђена из другог угла.
Сам LinkedIn то више не крије. У мају 2026. најавили су да ће смањивати домет објава које делују машински и не доносе ништа своје, појачати филтрирање аутоматских коментара и омогућити кориснику да ограничи „feed“ на верификоване профиле.
Платформа која је годинама подстицала људе да сваког дана нешто објаве, сада покушава да потисне управо садржај чије је настајање сама подстакла.
Сплачине у фирми
Овај део ме, као некога ко доноси одлуке у фирми, занима највише, јер се не мери у лајковима него у радним сатима.
У септембру 2025. истраживачи са Станфорда и из компаније BetterUp објавили су у часопису Harvard Business Review текст о појави коју су назвали workslop. Реч је о радном материјалу направљеном помоћу вештачке интелигенције који на први поглед делује као завршен посао, али онај ко га добије не може ништа корисно да уради с њим. Истраживање је обухватило 1.150 запослених у САД.
Четрдесет одсто испитаника навело је да је током претходног месеца добило такав материјал од неког колеге. На разумевање, исправљање или поновни рад на том послу трошили су у просеку сат и педесет шест минута. Према рачуници истраживача, тај губитак кошта око 186 долара месечно по запосленом, што у организацији са хиљаду људи премашује деветсто хиљада долара годишње.
Мени се чини да ова рачуница делује мало натегнуто, јер почива на процени самих испитаника о томе колико су времена изгубили, а људи сопствено време не процењују нарочито поуздано. Зато овај губитак треба схватити као показатељ размере проблема, а не као ставку коју треба убацити у буџет.
Много ми је важнији други налаз овог истраживања. Он показује шта се после таквог материјала, који је направљен помоћу AI-ја, дешава међу људима. Отприлике половина испитаника рекла је да је колегу који им је послао такав материјал сматрала мање креативним и мање способним. Код 42 одсто опало је поверење у пошиљаоца, док га је 37 одсто сматрало мање паметним него раније.
Човек који вам пошаље извештај од дванаест страна, који је направио за два минута, верује да је показао колико је ефикасан. Ви у истом том извештају видите колико је мало марио за ваше време. Обоје гледате у исти документ, али не видите исту ствар.
При томе, готово нико не жели да призна колико се ослања на вештачку интелигенцију. У истом истраживању 61 одсто запослених навело је да избегава да каже када ју је користило, док је њих 55 одсто материјал који је направила вештачка интелигенција представило као сопствени рад.
У јуну 2026. исти часопис је објавио текст Матијаса Холвега са Оксфорда и Томаса Дејвенпорта са Бебсон колеџа, у којем су указали на још један проблем о којем сам доста размишљао. Штета коју направи workslop се не завршава једном погрешном тврдњом. Када уредно написан, али непроверен материјал уђе у интерне базе знања и процедуре фирме, или постане оно из чега нова колегиница учи да ради додељени посао, грешка се више не налази само у једном документу. Она постаје део онога што фирма зна и што се преноси даље. А да би се то исправило, потребан је управо онај људски рад који је вештачка интелигенција требало да замени.
Школа, факултет и наука
Вратимо се на моје две гомиле, са почетка приче.
Анкета студентског листа Јејла међу студентима који су ове године завршили студије дала је занимљиве резултате: 91 одсто је користило вештачку интелигенцију за школске обавезе, 64 одсто за писање радова, 48 одсто за завршни рад. У Британији је удео студената који користе генеративне алате при изради задатака са 53 одсто у 2024. порастао на 88 у 2025. и више од 90 у 2026. Код средњошколаца у Америци, College Board је за 2025. измерио 84 одсто.
Наставници су у коришћењу вештачке интелигенције слабији него што то волимо да признамо. У једном прегледу, више од половине наставног особља није успешно препознавало машински текст. Ни алати који би то требало да раде уместо њих нису много бољи: у студији четрнаест детектора, стопе лажно позитивних резултата ишле су и до 50 одсто, а машински текст који је човек ручно дотерао промакао је у половини случајева. Најгоре од свега, текстови људи којима енглески није матерњи језик погрешно су означавани као машински у просеку од 61 одсто случајева.
У науци је слика још строжија, јер се тамо бележе појединачни промашаји. Број радова повучених због вештачке интелигенције порастао је са дванаест у 2022. на око 620 у 2025. Анализа објављена овог пролећа показала је да је у првих седам недеља 2026. један од 277 радова индексираних у PubMed-у имао измишљене референце. У једном Elsevier-овом часопису објављен је рад који почиње реченицом којом ChatGPT уводи свој одговор кориснику: „Certainly, here is a possible introduction for your topic:“. Рад је прошао рецензију. Уредници су то приметили тек након што је научни рад објављен.
То је инфраструктура која пере сплачине и уводи их у научну литературу као трајну чињеницу.
Вештина која се развија брже него што се очекивало
А сад оно због чега сам уопште почео да пишем овај текст.
Група истраживача је 2025. направила оглед који волим баш зато што је једноставан. Дали су учесницима истраживања три стотине текстова, где су пола написали људи, а пола је написала машина, и тражили од њих да одреде који текст је написао човек а који машина. За сваку одлуку су тражили образложење.
Људи који не користе језичке моделе, или их користе али не за писање, нису били ништа бољи од случајног погађања. Тачно су препознавали машински текст у 56,7 одсто случајева, а људски текст погрешно проглашавали машинским у 51,7 одсто. Другим речима, нису морали ни да их читају. Могли су за сваки да бацају новчић. А притом су били врло сигурни у своје процене.
Људи који свакодневно користе моделе за писање (уређују, дотерују и преправљају машински текст) погађали су машински написан текст у 92,7 одсто случајева, при чему су људски текст погрешно прогласили машинским само у четири одсто случајева. Кад се узме већински глас њих петоро, промашили су тачно један текст од три стотине.
Ниједан од њих није прошао обуку за препознавање AI текста. Научили су да га препознају тако што су свакодневно радили са AI-јем.
Овај резултат је бољи од готово сваког комерцијалног детектора AI садржаја на тржишту. Чак и када је текст намерно парафразиран или пропуштен кроз алате за „хуманизацију“ текста, резултат је остао готово исти.
Кад су истраживачи прочитали образложења, показало се да се људи не ослањају само на речник и структуру реченице. Примећивали су уједначен, сувише углачан тон, предвидљив ток излагања и правилно сложене пасусе у којима је све на свом месту, али ништа не носи јасан ауторски печат. Сметале су им опште тврдње без конкретног искуства, сувишна објашњења онога што се подразумева, вештачки уравнотежени закључци и реченице које звуче уверљиво, али не откривају зашто је аутору нешто заиста важно.
И, што ми је најлепши налаз у целој причи, свако од њих је приметио нешто друго.
Иста вештина постоји и на другој страни, код људи који моделе уопште не користе: код уредника, лектора, људи који предају књижевност и код писаца са двадесет година искуства. Они је нису стекли свакодневним коришћењем вештачке интелигенције. Примећују кад реченица звучи добро, али иза ње не стоји ни мисао ни искуство; кад је поређење ефектно, али нема никакве везе са оним о чему аутор говори; кад текст именује осећање које нигде није успео да изазове; кад аутор није присутан у сопственом тексту. Машински текст им не делује страно зато што га је написала машина, већ зато што у њему препознају стару слабост: аутора који се сакрио иза уредних реченица и општих места.
Две групе које би се у готово свакој другој расправи нашле на супротним странама, они који најбоље познају алат и они који најбоље познају језик, овде долазе до истог закључка. Први препознају обрасце које модел непрестано понавља, а други осећају одсуство искуства и препознатљивог гласа. Када се око нечега сложе људи који свакодневно раде са машином и они који су читав радни век посветили људском језику, ту сагласност вреди схватити озбиљно.
Ко заправо стоји иза текста?
Враћам се на своје две гомиле и на испит који је уследио.
Нисам никога оптужио да је користио AI за писање семинарског рада. Нисам ни помињао детектор, јер сам га у међувремену и сам испробао и видео колико греши. Уместо тога, тражио сам од студената да ми свако од њих усмено одбрани свој рад. Имали су 10 минута за одбрану, без папира. Испред табле. Девет студената из мање гомиле одбранило га је без проблема. Из веће гомиле, њих седам је такође положило испит: писали су уз помоћ AI-ја, али су знали шта су написали и зашто. Остали нису.
То ме је научило нечему што ниједна статистика у овом тексту није могла да покаже. Slop се не одређује по томе ко је писао текст. То може бити и машински и људски текст. Slop је материјал иза којег нико не стоји: нико није до краја промислио о поруци текста, није проверио тврдње, није одмерио сваку реченицу и прихватио одговорност за написано. Проблем је у томе што је човек објавио машински текст а да га претходно није учинио својим.
И зато мислим да ће се у наредним годинама развијати бољи читаоци. По самој форми биће све теже разликовати машински текст од људског, а људи ће престати да питају „да ли је ово писала машина“ и почеће да питају оно што их је одувек заиста занимало: да ли ће овај текст икоме бити од користи и да ли је ико спреман да одговара ако је текст бескористан.
Извори коришћени у тексту: Merriam-Webster, Word of the Year 2025; Graphite, „AI Now Writes as Many Online Articles as Humans“; Stanford / Imperial College London / Internet Archive, „The Impact of AI-Generated Text on the Internet“; Originality.ai, студије о LinkedIn садржају (2025, јул 2026); Pangram; Niederhoffer и сарадници, „AI-Generated Workslop Is Destroying Productivity“, Harvard Business Review, септембар 2025; Holweg и Davenport, HBR, јун 2026; Russell и сарадници, „People who frequently use ChatGPT for writing tasks are accurate and robust detectors of AI-generated text“, arXiv 2501.15654; Yale Daily News, мај 2026; College Board; подаци о повлачењу радова и лажним референцама: Retraction Watch и STAT, мај 2026.
Не морате бити инжењер да бисте разумели AI
Једном недељно добићете текст о томе како AI мења пословање, образовање и одлучивање